檢索增強生成 · Agentic 模式 · 多代理架構
Naïve RAG(基礎型 RAG)
單篇 ↗Naïve RAG(基礎型 RAG)
技術核心: 這是 RAG 的最初始形式,採用傳統的「檢索-閱讀」工作流程
原理:
索引(Indexing):將原始資料轉成統一格式並分割資料,讓這些資料變成一個區塊(Chunks),利用Embedding技術轉成向量(Vector)存入向量資料庫
檢索(Retrieval):當User提出問題,把問題利用Embedding轉成向量,然後在資料庫裡面找到相似的資料(Chunk)
生成(Generation):檢索到的資料(Chunk)與問題一起給LLM,生成最終答案,過程中LLM可以利用檢索外部資料補充知識
機制: 依賴簡單的關鍵字檢索技術(如 TF-IDF 和 BM25)從靜態數據集中獲取文檔
優點:可以再不更改LLM內部的知識下,通過外部資料增強生成的準確性
缺點:
-
檢索問題:缺乏上下文意識和精確度可能不足,導致無法捕捉到語意細微差別或是LLM產生錯誤或不相關的答案
-
整合困難:檢索時可能會因為資訊過多或複雜,難以有效整合或處理,導致無法辨識最相關的資訊或是生成結果不一致
-
生成問題:LLM有時會生成不準確或不連貫的答案,甚至發生「幻覺」現象,導致輸出會呈現碎片
儘管有這些局限性,但樸素的 RAG 系統為將檢索與生成結合提供了重要的概念驗證,為更複雜的範式奠定了基礎
參考資料:https://ithelp.ithome.com.tw/m/articles/10349310
相關筆記
- Advanced RAG(高級 RAG):下一階段
- feature_engineering_rag_flow:實作:資料清洗、chunk、embedding 進向量庫
- RAG 系統架構圖
Advanced RAG(高級 RAG)
單篇 ↗Advanced RAG(高級 RAG)
優化Naive RAG「檢索」和「生成」階段
改進:
預檢索優化(Pre-Retrieval):
-
索引優化:改進索引結構讓檢索更高效
-
查詢優化:把User的問題進行改寫,讓問題更清楚、更適合檢索
後檢索優化(Post-Retrieval):
-
重新排序(Reranking):檢索到的資訊重新排序,把最相關的放到最前面
-
上下文壓縮(Context Compression):檢索過多資料就壓縮文字,保留核心資訊
技術核心: 引入了語義理解和強化的檢索技術以克服基礎型的限制。
機制: 使用密集檢索模型 (Dense Retrieval)(如 DPR)和神經重排序算法。其關鍵功能包括高維向量搜索、上下文重排序以及針對複雜問題的「多跳檢索」(Multi-hop retrieval)。
優點: 顯著提升了檢索的精確度和上下文相關性。
-
密集向量搜尋:查詢和文件在高維度向量空間中表示,從而能夠更好地實現使用者查詢和檢索到的文檔之間的語義對齊
-
上下文重排序:神經模型將檢索到的文件重新排序,以優先考慮與上下文最相關的資訊
-
迭代檢索:進階 RAG 引入了多跳檢索機制,能夠跨多個文件進行推理,以處理複雜的查詢
缺點:
-
系統變複雜,優化過程需要更多計算資源和時間
-
對於非常複雜或多變的任務,沒有辦法應對
這些進步使得高級 RAG 適用於需要高精度和細緻理解的應用,例如研究綜合和個人化推薦。然而,計算開銷和可擴展性有限等挑戰依然存在,尤其是在處理大型資料集或多步驟查詢時。
參考資料:https://ithelp.ithome.com.tw/m/articles/10349310
相關筆記
- Naïve RAG(基礎型 RAG):前一階段
- 模組化 RAG (Modular RAG):下一階段
- RAG 系統架構圖:Query Enhancement、Semantic Cache 的實際架構
- 中國醫RAG專案說明:實例:訓練 dense retriever(Contriever)
- 第四章LLM:讀書筆記中的進階 RAG
模組化 RAG (Modular RAG)
單篇 ↗模組化 RAG (Modular RAG)
它很像樂高積木,每個模組獨立運作,但可以建構成一個靈活可用的系統,它打破傳統RAG「檢索-生成」的單線流程,像是重寫-檢索-生成、生成-閱讀、遞迴檢索
技術核心: 強調系統的靈活性與可定制性,將流程分解為獨立的組件
EX:
-
檢索模組:針對不同資料來源,設計專門的檢索策略
-
記憶模組:可以記住以前檢索結果,變成一個記憶池讓LLM可以在後續任務使用以前的資料
機制: 結合了混合檢索策略(同時使用關鍵字和向量檢索)以及外部工具與 API 的整合(例如串接即時股價 API)
優點: 組件可獨立更換或優化,使其非常適合處理複雜的多領域任務
-
混合檢索策略:將稀疏檢索方法(例如稀疏編碼器-BM25)與密集檢索技術[21](例如 DPR - 密集段落檢索)相結合,以最大限度地提高各種查詢類型的準確性。
-
工具整合:整合外部 API、資料庫或運算工具來處理專門的任務,例如即時資料分析或特定領域的運算
-
可組合管道:模組化 RAG 允許檢索器、生成器和其他組件獨立地進行替換、增強或重新配置,從而能夠高度適應特定的用例
缺點:
- 大部分功能需要客製化,所以難用一種解決方案應付所有領域的問題
參考資料:https://ithelp.ithome.com.tw/m/articles/10349310
相關筆記
- Advanced RAG(高級 RAG):前一階段
- Agentic RAG(代理型 RAG):下一階段
Graph RAG (圖譜 RAG)
單篇 ↗Graph RAG (圖譜 RAG)
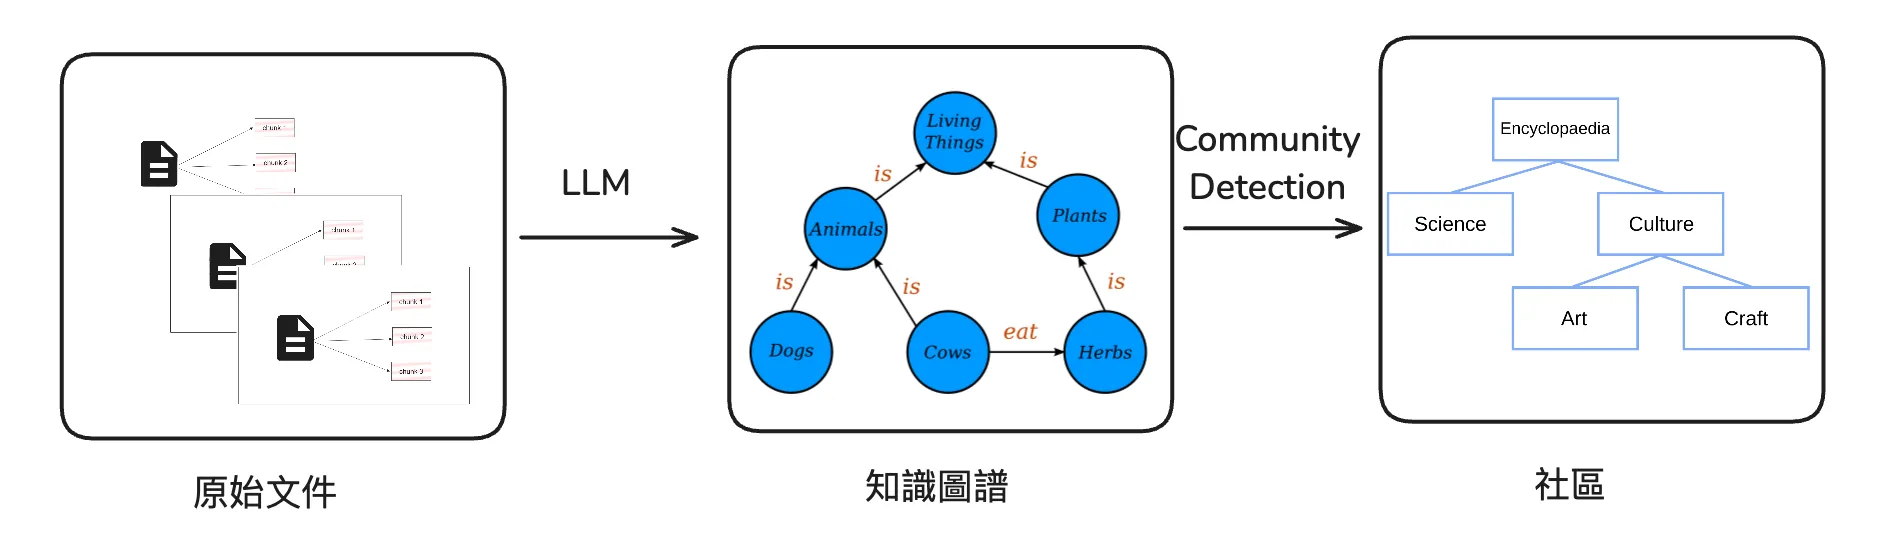
利用資料結構裡面的圖擴展傳統的RAG,它的流程是從原始文件提取知識圖譜,建立社群層級結構
特徵:
-
節點連結性(Node Connectivity):捕捉和分析實體之間的關係(圖譜提取(Graph Exxtraction).md)
-
層級式知識管理(Hierarchical Knowledge Management):透過基於圖表的層級結構處理結構化和非結構化資料
-
情境豐富化(Context Enrichment):利用基於圖的路徑增加關係理解
-
社群摘要生成(Community Summary Generation):採用由下而上的方法,為每個社群及其成員產生摘要
參考資料:
https://www.chttl.com.tw/_news/n_tech32.html
https://ithelp.ithome.com.tw/articles/10348910
https://microsoft.github.io/graphrag/
相關筆記
- 圖譜提取(Graph Exxtraction):建圖的方法
- rag_session_summary:什麼時候需要 GraphRAG
- graphify-研究筆記:工具:把專案轉成知識圖譜
- RAG 系統架構圖:Router 分流到 Knowledge Graph
圖譜提取(Graph Exxtraction)
單篇 ↗圖譜提取(Graph Exxtraction)
將資料來源切成Chunks,然後提取實體和(Entities)關係(Relationships),最後彙整實體和關係來進行分類,形成知識圖譜
參考資料:
https://ithelp.ithome.com.tw/articles/10348910(圖片從裡面抓到的)
相關筆記
- Graph RAG (圖譜 RAG)
- graphify-研究筆記:自動圖譜提取工具
AI Agent
單篇 ↗AI Agent
Components(組成) of an AI Agent
LLM,Memory,Planning,Tools Vector Search,Web Search,APIs,etc.
相關筆記
- Tool Use(工具使用)
- Planning(規劃)
- Reflection(反思)
- Multi-Agent(多代理協作)
- hermes-agent-研究報告:Agent 框架實例
- Harness-Engineering-研究筆記:Agent 的運行環境設計
Reflection(反思)
單篇 ↗Reflection(反思)
這是整個流程最基礎的設計,它會去反思(自我回饋)或是評估這個答案是否正確或是否為最佳化,它就會一直去迭代,若過程中有錯誤它就會去改進,最後輸出內容
相關筆記
Planning(規劃)
單篇 ↗Planning(規劃)
它是整個流程核心的設計,它會去把複雜的問題拆解成很多個小問題或簡單的問題,讓整個流程可以按照這些小問題來把複雜的問題給解決
相關筆記
- Orchestrator-Workers(協調者-執行者)
- SADE:網路領域實例:用排障 SOP 約束 agent 的規劃
Tool Use(工具使用)
單篇 ↗Tool Use(工具使用)
有時候LLM可能沒有這個問題的答案或是沒有預訓練到這個部分,它就可以調用外部工具、API、或是其他工具來提供更準確的答案
相關筆記
- function_calling_llm:Tool Use 的底層機制
- llm-研究筆記:CLI 工具中的 tool calling
- Backend Flow:實作:智慧客服的 Tool Services
Multi-Agent(多代理協作)
單篇 ↗Multi-Agent(多代理協作)
就是現在每個Agent都一個專業領域的專家,現在這些人在一個團隊,如果有問題,會把問題給專門的專家回答,分工合作
相關筆記
- Multi-Agent Agentic RAG Systems:在 RAG 中的應用
- MAS-SLM-Telecom-Troubleshooting:網路領域實例:多代理排障
- Confucius:網路領域實例
Prompt Chaining(提示鏈)
單篇 ↗Prompt Chaining(提示鏈)
它就像工廠的流水線,流程固定,一條直直的過去,但是速度太慢
相關筆記
Routing(路由)
單篇 ↗Routing(路由)
會對於問題進行分類,並把相對應的問題丟給相應的LLM處理,提高效率與回應品質
就像醫院會把病人做檢傷分類,把對應的傷給對應的醫生看
相關筆記
- Single-Agent Agentic RAG! Router:在 RAG 中的應用
- Adaptive Agentic RAG:依難度路由
- RAG 系統架構圖:實際架構中的 Router
Parallelization(平行化)
單篇 ↗Parallelization(平行化)
把問題丟給每個LLM做處理,然後最後去做統整
它分為分段式(Sectioning)跟投票式(Voting)
分段式(Sectioning):像是把任務分成前後半段
投票式(Voting):大家一起做,最後來投票,看誰的答案好
相關筆記
- Orchestrator-Workers(協調者-執行者):子任務由協調者動態決定的版本
- Prompt Chaining(提示鏈):序列版本
Orchestrator-Workers(協調者-執行者)
單篇 ↗Orchestrator-Workers(協調者-執行者)
就像有一個新專案會先給PM(專案經理),它會看裡面的每個任務,會看情況動態決定:「今天需要找工程師和設計師開會」,而不是死板的流水線,所以它跟路由最大的差別就是路由會預先設定這個問題誰負責,而協調者-執行者會自己決定需要給誰,不會預先設定
相關筆記
- Parallelization(平行化)
- Hierarchical Agentic RAG Systems:在 RAG 中的應用
- Confucius:網路領域實例:Meta 多代理網管
Evaluator-Optimizer(評估者-優化者)
單篇 ↗Evaluator-Optimizer(評估者-優化者)
就像有兩個人,一個是作家,一個是編輯,當作家寫好稿之後,編輯會看,然後給作家回饋和建議,然後作家再改,反覆循環,直到滿意為止
什麼時候使用:當品質比速度重要的時候,或是有明確評估標準時
相關筆記
- Reflection(反思)
- Agentic Corrective RAG:在 RAG 中的應用
Agentic RAG(代理型 RAG)
單篇 ↗Agentic RAG(代理型 RAG)
傳統RAG和AI Agent概念的創新架構
特徵:
-
自主決策:具備反思、規劃、工具調用等功能,提供管理檢索策略
-
迭代改進:引入回饋迴路,以提高檢索準確性和回應相關性
-
工作流程最佳化:動態協調任務,提高即時應用程式的效率
面臨挑戰:
-
協調複雜性
-
計算開銷
-
可擴展性限制
相關筆記
- 模組化 RAG (Modular RAG):前一階段
- Single-Agent Agentic RAG! Router:單代理架構
- Agentic Corrective RAG
- Adaptive Agentic RAG
- Multi-Agent Agentic RAG Systems:多代理架構
- Hierarchical Agentic RAG Systems:階層式架構
- Backend Flow:實作:智慧客服的 Agentic RAG Tool 流程
- 2026-06-07-AI-research:論文:Agentic retrieval 新方向
Single-Agent Agentic RAG! Router
單篇 ↗Single-Agent Agentic RAG: Router
工作流程:
-
Query Submission and Evaluation(查詢提交和評估)
-
Knowledge Source Selection
-
Structured DB(結構化資料庫)
-
Semantic Search(語意搜尋)
-
Web Search
-
Recommendation Systems(推薦系統)
-
-
Data Integration and LLM Synthesis(資料整合與大型語言模型合成)
-
Output Generation
特點與優勢:
-
Centralized Simplicity(集中是簡易型)
-
Efficiency & Resource Optimization(效率和資源最佳化)
-
Dynamic Routing(動態路由)
-
Versatility Across Tools(工具通用性)
-
Ideal for Simpler Systems(適用於簡單的系統)
相關筆記
- Routing(路由):底層設計模式
- Agentic RAG(代理型 RAG):總覽
Multi-Agent Agentic RAG Systems
單篇 ↗Multi-Agent Agentic RAG Systems
工作流程:
-
Query Submission
-
Specialized Retrieval Agents(專用檢索代理)
- 可能會有好幾個代理去做不同的事情,像是代理一可能會去查資料庫,而代理二去web查資料,而代理三則是調用API查詢等等
-
Tool Access and Data Retrieval(工具存取和資料擷取)
-
Vector Search
-
Text-to-SQL
-
Web Search
-
APIs
-
-
Data Integration and LLM Synthesis
-
Output Generation
特點與優勢:
-
Modularity
-
Scalability(可擴充性)
-
Task Specialization(任務專業化)
-
Efficiency:指的是給專門的代理,可以減少知識量不足的問題,提高了複雜工作流程的效能
挑戰:
-
Coordination Complexity(協調複雜性)
-
Computational Overhead(計算開銷)
-
Data Integration(資料整合):因為使用不同的LLM,所以要把輸出綜合起來不簡單
相關筆記
- Multi-Agent(多代理協作):底層設計模式
- Hierarchical Agentic RAG Systems:加上階層的版本
- Agentic RAG(代理型 RAG):總覽
Hierarchical Agentic RAG Systems
單篇 ↗Hierarchical Agentic RAG Systems
工作流程:
-
Query Reception(查詢接收)
-
Strategic Decision-Making(策略決策)
-
Delegation to Subordinate Agents(分派給下級代理)
-
Aggregation and Synthesis(聚合與綜合)
-
Response Delivery(回應交付)
特點與優勢:
-
Strategic Prioritization(策略優先排序)
-
Scalability(可擴充性)
-
Enhanced Decision-Making(增強決策能力)
挑戰:
-
Coordination Complexity(協調複雜性)
-
Resource Allocation(資源分配)
相關筆記
Agentic Corrective RAG
單篇 ↗Agentic Corrective RAG
Corrective RAG想法:引入了自我修正的檢索機制,能夠動態評估檢索的文檔,糾正以提高優化查詢與生產品質
調整 Corrective RAG方法:
-
Document Relevance Evaluation(文件相關性評估)
-
Query Refinement and Augmentation(查詢最佳化和增強)
-
Dynamic Retrieval from External Sources(從外部來源動態檢索)
-
Response Synthesis(回應合成)
工作流程:
-
Context Retrieval Agent(上下文檢索代理)
-
Relevance Evaluation Agent(相關性評估代理)
-
Query Refinement Agent(查詢最佳化代理)
-
External Knowledge Retrieval Agent(外部知識檢索代理)
-
Response Synthesis Agent(響應合成代理)
特點和優勢:
-
Iterative Correction(迭代糾錯):用動態辨識和修正步相關或模糊的檢索結果,提高準確性
-
Dynamic Adaptability(動態適應性):結合即時網路搜尋與查詢最佳化
-
Agentic Modularity(代理模組化)
-
Factuality Assurance(事實性保證):最大降低幻覺或是錯誤資訊的風險
相關筆記
- Reflection(反思):自我修正的設計模式
- Evaluator-Optimizer(評估者-優化者):評估檢索結果再修正
- Agentic RAG(代理型 RAG):總覽
Adaptive Agentic RAG
單篇 ↗Adaptive Agentic RAG
Adaptive RAG想法:會根據傳入的查詢複雜度來動態調整處理的策略,白話就是會先看一眼這個問題的難易度,看要丟給誰去做處理
調整Adaptive RAG方法:
-
Straightforward Queries(直接查詢)
-
Simple Queries
-
Complex Queries(複雜查詢)
工作流程:
-
Classifier Role(分類器角色)
-
用比較小的LLM來看問題的難易度
-
會自動標記資料集進行訓練,資料集可能來自過去LLM的結果或是查詢模式
-
-
Dynamic Strategy Selection(動態策略選擇)
-
非常簡單問題直接給LLM
-
簡單問題,就用單步檢索過程取得上下文
-
複雜問題,啟動多步驟檢索,確保迭代改進和增強推理
-
-
LLM Integration(LLM整合)
-
將檢索到的資訊做同整
-
與分類器之間可分別複雜查詢進行細化
-
特點與優勢:
-
Dynamic Adaptability(動態適應性)
-
Resource Efficiency(資源效率)
-
Enhanced Accuracy(提高準確性)
-
Flexibility(靈活性)
相關筆記
- Routing(路由):依查詢複雜度選擇策略
- Agentic RAG(代理型 RAG):總覽